别信什么‘AI明天就能自己造自己’——那不是预告片,是营销PPT。上海交大、清华、字节联合那篇75页论文早就摊开说了:现在所有号称在搞RSI(递归自我改进)的系统,95%还卡在L1和L2,连‘自己决定怎么改自己’这关都没过。真正能递归的?不到6%。但有意思的是,这篇论文没泼冷水,反而指了条路:RSI不是用来锦上添花的,它是专治‘能力瘸腿’的——比如软件工程HCI才52.6配资实力股票配资网站,法律推理刚过64,这些地方不是AI太强,而是太弱,弱到必须靠它自己来补课。
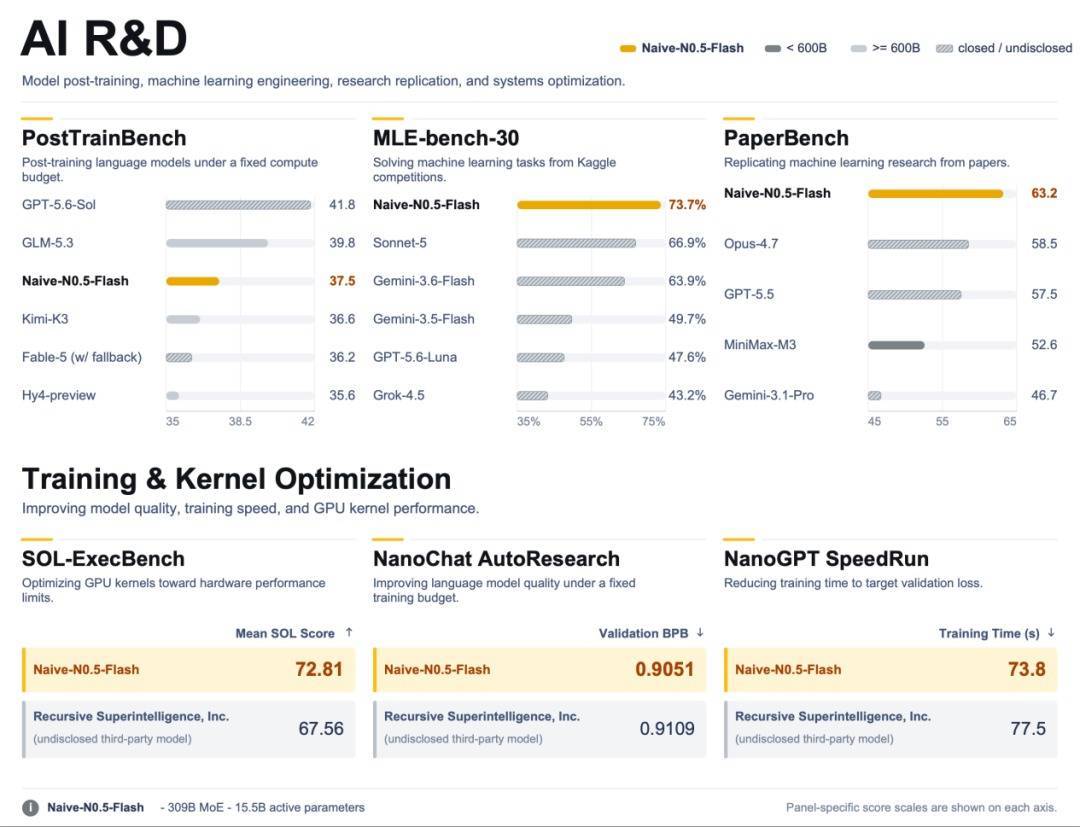
这时候,后训练就真成了主战场。预训练拼算力、拼数据,但后训练拼的是‘怎么让模型在真实研发流里活下来’。Naive AI刚开源的Naive-N0.5-Flash就是个典型:309B参数、15.5B激活、原生支持百万token上下文,不从头训,专攻编程与AI研发场景。它不是被人类手把手调出来的,而是由AI参与设计、验证、迭代的‘产儿’,反过来又被训练去写训练脚本、跑消融实验、审核合成数据。换句话说,它既是RSI的‘考生’,也是‘监考老师’之一。
为什么偏偏是后训练?因为RSI最需要的不是‘更聪明’,而是‘更懂怎么学’。像RISE那种让模型用‘未来的自己’当老师的方法,或者NeoHorse-1那种靠完整交互轨迹而非问答对来训练的方式,全得靠后训练阶段注入。你没法在预训练里塞进‘调试GPU内核’或‘重试失败的Agent工作流’这种经验。OpenAI说2028年要让AI接管全流程研发,Anthropic内部3万Agent日夜沙盒跑测——这些都不是靠堆卡跑出来的,是靠一次又一次后训练,把‘试错-反馈-修正’这个闭环,硬生生焊进模型的行为逻辑里。
这事儿其实挺像学骑自行车。预训练是给你造了辆崭新的车,链条锃亮、轮胎充气足,但你坐上去一蹬就摔——不是车不行,是你没练过平衡、没试过错觉、没感受过急刹时重心怎么偏。后训练,就是让你扶着墙、摔了十次、膝盖破皮三次之后,终于不用人扶也能晃晃悠悠骑出一百米的那段过程。
而且现在连“扶墙”都开始智能化了。清华和智谱刚开源的AutoTune框架,已经能自动识别模型在代码生成中反复卡壳的函数签名错误,然后动态生成针对性微调数据集,再调度小规模GPU集群跑三轮验证——整个流程人类只点了一次确认键。这不是“AI替代人”,是“人把经验打包成可复用的调试本能”,再喂给下一个AI。
更实在的变化发生在企业端。华为昇腾团队透露,他们用后训练把盘古大模型在EDA工具链中的RTL代码生成准确率,从61.3%拉到89.7%,关键不是换了更大模型,而是把芯片验证工程师过去三年积累的27类典型报错模式,编译成了可嵌入训练循环的“纠错token”。这些token不教模型写多漂亮的代码,只教它:“这里别漏括号”“时序约束必须带posedge”“综合前先检查异步复位”——全是血泪教训,一句顶一万条规则文档。
所以别被“AGI倒计时”的标题党带跑。真正推着RSI往前蹭的,不是某个惊天突破,而是每天凌晨两点还在跑消融实验的工程师,是把第137版prompt改成“请以IC设计老手口吻重写这段Verilog”的产品经理,是那个把合成数据里所有“undefined behavior”手动打上风险标签的实习生。他们没在造神,只是让AI学会:什么叫靠谱,什么叫别翻车,什么叫——干研发这行,得对自己写的每一行代码负责。
这活儿没法速成,但可以累积。就像交大论文里写的那句大实话:“RSI不是终点线配资实力股票配资网站,是研发流水线上又一道质检工位。”而工位上站着的,从来都不是AI自己,而是人和AI一起拧紧的那颗螺丝。
炒股配资提示:文章来自网络,不代表本站观点。
相关文章
沪深京指数
热点资讯